如何构建截图文字知识图谱?
截图文字知识图谱构建
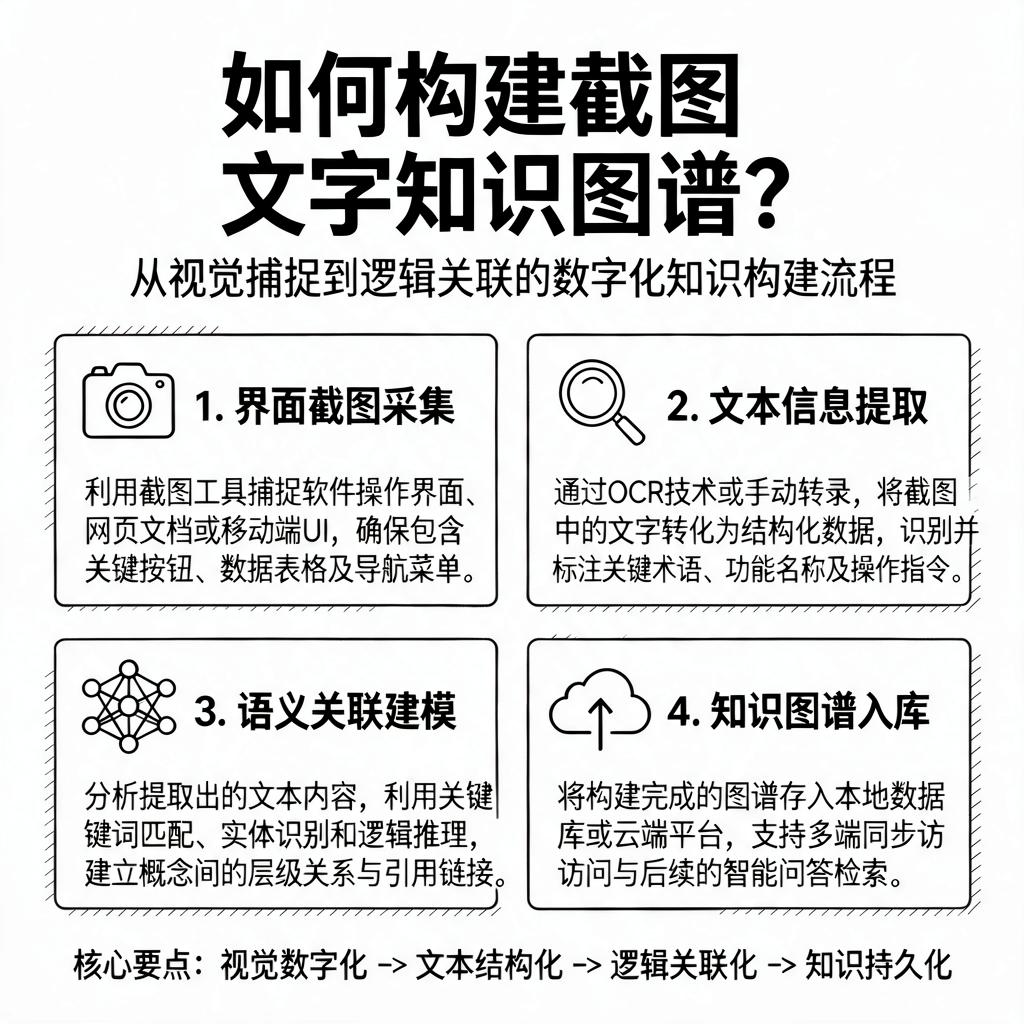
想要构建一个基于截图文字的知识图谱,其实并不复杂,但需要一步步来操作。先要明确,知识图谱的核心是把文字信息中的实体和它们之间的关系用结构化的方式呈现出来。对于截图中的文字,第一步是提取出有用的内容,这一步很关键,因为只有提取准确了,后续的构建才有意义。
具体操作时,可以借助一些OCR(光学字符识别)工具,比如百度OCR、腾讯OCR或者一些开源的工具,它们能将截图中的文字识别并转换成可编辑的文本格式。这一步要注意,尽量选择识别准确率高的工具,减少后续的修正工作。如果截图中的文字比较清晰,识别效果通常会很好;如果文字模糊或者有遮挡,可能需要手动调整一下识别结果。
识别出文字后,接下来就是分析这些文字,找出其中的实体和关系。实体可以是人名、地名、组织名、概念名等,关系则是这些实体之间的联系,比如“属于”“位于”“合作”等。举个例子,如果截图中的文字是“苹果公司位于美国加利福尼亚州”,那么实体就是“苹果公司”和“美国加利福尼亚州”,关系就是“位于”。这一步可能需要一些自然语言处理的知识,但如果只是简单的知识图谱,也可以手动分析,把实体和关系一一列出来。
有了实体和关系后,就可以开始构建知识图谱了。知识图谱通常用图的形式来表示,可以用一些专业的工具,比如Neo4j、Gephi,或者一些在线的图谱构建平台。这些工具大多支持导入实体和关系的数据,然后自动生成图谱。如果不想用专业工具,也可以用Excel来整理数据,把实体放在一列,关系放在另一列,再通过一些简单的绘图工具手动绘制图谱,虽然效率低一些,但对于小规模的知识图谱来说也是可行的。
在构建图谱的过程中,要注意数据的准确性和完整性。如果实体或关系有遗漏或错误,图谱的质量就会大打折扣。因此,在提取文字、分析实体和关系时,都要反复检查,确保没有遗漏或错误。另外,知识图谱的构建是一个迭代的过程,可能需要多次调整和优化,才能得到一个满意的结果。
最后,构建好的知识图谱可以用于很多场景,比如信息检索、知识推理、智能问答等。通过知识图谱,可以更直观地看到实体之间的关系,帮助更好地理解和利用这些信息。如果截图中的文字内容很多,构建的知识图谱也会更复杂,但只要按照上述步骤一步步来,就能完成一个有用的知识图谱。
总之,构建截图文字的知识图谱,关键在于准确提取文字、分析实体和关系、选择合适的工具进行构建,并不断优化和调整。这个过程虽然需要一些耐心和细心,但完成后会很有成就感,也能为后续的信息处理和应用提供很大的帮助。
截图文字知识图谱构建方法有哪些?
截图文字知识图谱的构建是一个结合了图像处理、文字识别和知识图谱技术的综合过程。对于想要了解如何构建截图文字知识图谱的用户来说,以下是详细且具有实操性的步骤和方法。
第一步,图像预处理。在开始构建知识图谱之前,需要对截图进行预处理。这一步的目的是提高后续文字识别的准确率。预处理包括图像的裁剪、去噪、增强对比度等操作。可以使用图像处理软件,如Photoshop,或者编程语言中的图像处理库,如OpenCV,来完成这些任务。确保截图中的文字清晰可辨,背景干扰最小化。
第二步,文字识别。接下来,使用OCR(光学字符识别)技术将截图中的文字提取出来。市面上有许多成熟的OCR工具可供选择,如百度OCR、腾讯OCR等,它们提供了API接口,方便开发者集成到自己的应用中。选择适合的OCR工具后,按照其文档说明进行调用,将截图中的文字转换为可编辑的文本格式。
第三步,文本清洗与标准化。OCR识别出的文本可能包含一些错误或不一致的地方,如错别字、格式混乱等。因此,需要对识别出的文本进行清洗和标准化处理。这包括纠正错别字、统一文本格式、去除无关字符等。可以使用正则表达式、字符串处理函数等工具来完成这些任务。
第四步,实体识别与关系抽取。在清洗和标准化后的文本基础上,进行实体识别和关系抽取。实体识别是指识别出文本中的关键名词,如人名、地名、组织名等。关系抽取则是识别出这些实体之间的关系,如“属于”、“位于”等。可以使用自然语言处理(NLP)技术,如命名实体识别(NER)和关系抽取模型,来完成这一步。这些模型可以通过训练得到,也可以使用现成的NLP库,如spaCy、NLTK等。
第五步,知识图谱构建。在识别出实体和关系后,就可以开始构建知识图谱了。知识图谱通常由节点和边组成,节点代表实体,边代表实体之间的关系。可以使用图数据库,如Neo4j,来存储和管理知识图谱。将识别出的实体作为节点,关系作为边,按照图数据库的语法规则进行存储。
第六步,可视化与交互。构建好知识图谱后,为了方便用户查看和交互,可以将其可视化。可以使用图可视化工具,如D3.js、Gephi等,将知识图谱以图形化的方式展示出来。用户可以通过点击节点或边来查看详细信息,或者进行进一步的查询和分析。
第七步,持续优化与更新。知识图谱的构建是一个持续的过程。随着新截图的加入和旧截图的更新,需要不断对知识图谱进行优化和更新。这包括重新进行文字识别、实体识别和关系抽取等步骤,以确保知识图谱的准确性和时效性。
通过以上步骤,就可以完成截图文字知识图谱的构建了。这个过程虽然涉及多个技术领域,但只要按照步骤逐一进行,就能够顺利完成。希望这些信息能够帮助到想要了解截图文字知识图谱构建方法的用户。
截图文字知识图谱构建工具推荐?
想要构建一个截图文字知识图谱,选择合适的工具能让整个过程更加顺畅高效。下面为你推荐几款好用的工具,它们各有特点,能满足不同场景下的需求。
首先是 ABBYY FineReader。这款工具功能十分强大,它对文字的识别准确率相当高。当你对截图中的文字进行识别时,它能精准地把文字提取出来,哪怕是字体比较特殊或者排版较为复杂的截图也不在话下。提取完文字后,它支持将文字信息导出为多种格式,比如常见的文本格式、Excel 表格格式等,方便你后续对文字内容进行整理和分析。在构建知识图谱时,你可以利用它导出的结构化数据,快速搭建起知识图谱的节点和关系。操作上,它的界面简洁直观,即使你是初次使用,也能很快上手。导入截图后,选择识别功能,稍等片刻就能得到识别结果,再进行简单的格式调整就能为知识图谱构建所用。
接着是 Adobe Acrobat Pro DC。很多人知道它是一款强大的 PDF 处理工具,但其实它在截图文字识别和知识图谱构建方面也有出色表现。它具备优秀的 OCR(光学字符识别)技术,能快速准确地将截图中的文字转化为可编辑的文本。对于包含大量文字信息的截图,它能高效地完成识别任务。识别后的文字可以方便地进行编辑、复制和粘贴操作。在构建知识图谱时,你可以把识别出来的文字整理成有逻辑的内容,再借助其他专门的知识图谱构建软件或者在线工具,将这些内容转化为知识图谱的各个元素。而且,Adobe Acrobat Pro DC 还能对识别后的文档进行各种格式转换,满足你不同的使用需求。
还有 Online OCR 这款在线工具。它最大的优势就是无需下载安装,直接在网页上就能使用。对于一些临时需要处理截图文字构建知识图谱的情况非常方便。你只需打开它的网页,上传截图文件,选择合适的识别语言和输出格式,点击识别按钮,很快就能得到识别结果。它支持的格式也比较丰富,能满足基本的文字识别需求。识别完成后,你可以将结果复制下来,按照知识图谱的构建规则,手动或者借助其他工具将其整理成知识图谱。虽然它是在线工具,但识别速度和准确率都有保障,适合对工具便携性有要求的用户。
最后推荐 Readiris。它同样是一款专业的 OCR 软件,对截图文字的识别能力很强。它不仅能识别普通截图中的文字,对于一些质量不太高的截图,也能通过其智能算法尽可能准确地提取文字信息。识别后的文字可以进行多种操作,比如校对、编辑、格式转换等。在构建知识图谱时,你可以利用它提供的文本处理功能,对识别出来的文字进行优化,使其更符合知识图谱的构建要求。它的操作流程简单易懂,从导入截图到识别文字,再到导出结果,每一步都有清晰的指引,即使是没有太多技术基础的用户也能轻松完成。
以上这些工具都能帮助你处理截图文字,为构建知识图谱提供有力的支持。你可以根据自己的具体需求和使用习惯,选择最适合自己的工具。希望这些推荐能让你在构建截图文字知识图谱的道路上更加顺利。
截图文字知识图谱构建步骤详解?
想要构建一个截图文字知识图谱,其实是一个结合了图像处理、文字识别以及图谱构建技术的综合过程。下面一步步来详细讲解这个过程,确保即使是小白也能轻松上手。
第一步,准备截图素材。你得先有一系列包含文字的截图,这些截图可以来自网页、文档、图片等任何含有文字信息的来源。确保截图清晰,文字可辨认,这是后续处理的基础。
第二步,文字识别(OCR)。使用OCR(光学字符识别)技术,将截图中的文字提取出来。现在市面上有很多OCR工具,比如百度OCR、腾讯OCR等,它们大多提供API接口,方便开发者集成到自己的项目中。选择一款合适的OCR工具,按照其文档说明进行调用,就能轻松获取截图中的文字信息。
第三步,文字预处理。提取出来的文字可能包含一些噪声,比如多余的空格、换行符,或者识别错误导致的乱码。这时候需要进行文字预处理,包括去除多余空格、换行,修正识别错误等,确保文字信息的准确性和整洁性。
第四步,实体识别与关系抽取。知识图谱的核心是实体和它们之间的关系。在这一步,你需要识别出文字中的实体,比如人名、地名、机构名等,并抽取它们之间的关系。这可能需要借助自然语言处理(NLP)技术,比如命名实体识别(NER)和关系抽取模型。如果你对NLP不太熟悉,也可以考虑使用现成的NLP工具或服务,它们往往能提供实体识别和关系抽取的功能。
第五步,构建知识图谱。有了实体和它们之间的关系,就可以开始构建知识图谱了。知识图谱通常由节点(代表实体)和边(代表关系)组成。你可以选择使用图数据库(如Neo4j)来存储和管理知识图谱,也可以自己设计数据结构来存储。在构建过程中,要注意实体和关系的唯一性,避免重复和冗余。
第六步,可视化展示。知识图谱构建完成后,为了方便查看和理解,可以将其可视化展示。有很多工具可以帮助你实现这一点,比如Gephi、D3.js等。它们能将知识图谱以图形的方式呈现出来,让你更直观地看到实体之间的关系和整个图谱的结构。
第七步,持续优化与更新。知识图谱不是一成不变的,随着新数据的加入和旧数据的更新,你需要不断对知识图谱进行优化和更新。这包括修正错误的实体和关系、添加新的实体和关系等。同时,也要关注OCR和NLP技术的最新进展,及时升级你的工具和服务,提高知识图谱的准确性和完整性。
通过以上七个步骤,你就能构建出一个截图文字知识图谱了。这个过程虽然涉及多个技术领域,但只要一步步来,即使是对技术不太熟悉的小白也能轻松掌握。希望这个详解能对你有所帮助!
截图文字知识图谱构建难点及解决?
在构建截图文字知识图谱时,会遇到不少难点,不过别担心,下面会详细介绍这些难点以及对应的解决办法。
第一个难点是文字识别准确率问题。截图中的文字可能因为字体、大小、颜色、背景复杂度等因素,导致识别不准确。比如,一些艺术字体或者手写体,普通的文字识别工具很难准确识别出来。还有,当文字颜色和背景颜色相近时,也会增加识别难度。解决办法是选择更先进的文字识别技术,像一些基于深度学习的OCR(光学字符识别)工具,它们经过大量数据的训练,对各种字体和复杂背景的适应能力更强。同时,在截图前可以尽量优化文字显示,比如选择清晰易读的字体,调整文字和背景的对比度,让文字更突出。
第二个难点是信息抽取的准确性。从识别出来的文字中提取出有用的信息来构建知识图谱,这并不容易。文字中可能包含很多无关信息,而且信息的表达形式多样,有的是直接陈述,有的是隐含的。例如,在一篇新闻截图里,要准确提取出事件的时间、地点、人物等关键信息,需要复杂的自然语言处理技术。可以采用自然语言处理中的命名实体识别技术,它能识别出文字中的人名、地名、组织名等实体。还可以利用信息抽取算法,根据预设的规则和模型,从大量文字中筛选出有价值的信息。同时,不断优化算法和模型,通过大量的标注数据进行训练,提高信息抽取的准确性。
第三个难点是知识图谱的关联和整合。截图中的文字信息往往是零散的,要把这些零散的信息关联起来,形成一个完整的知识图谱,需要解决很多问题。比如,不同截图中的信息可能存在重复或者矛盾的情况,如何识别和处理这些问题是一大挑战。可以建立统一的知识表示模型,为每个实体和关系定义明确的属性和规则。在整合信息时,通过比对实体的属性和关系,判断信息是否重复或者矛盾。对于重复的信息,可以进行合并;对于矛盾的信息,需要进一步分析,确定正确的信息。还可以利用图数据库来存储和管理知识图谱,图数据库能高效地处理实体之间的关系,方便进行关联和查询。
第四个难点是数据更新和维护。随着时间的推移,截图中的信息可能会发生变化,知识图谱也需要及时更新。但是,手动更新知识图谱效率低下且容易出错。可以建立自动化的数据更新机制,通过监测信息源的变化,比如定期抓取相关网页或者文件,当发现有新的截图或者截图中的信息有更新时,自动触发知识图谱的更新流程。同时,建立数据审核机制,对更新后的知识图谱进行审核,确保信息的准确性和一致性。
通过以上这些方法,可以有效地解决截图文字知识图谱构建过程中遇到的难点,构建出高质量的知识图谱。