如何实现截图文字表格结构化提取?
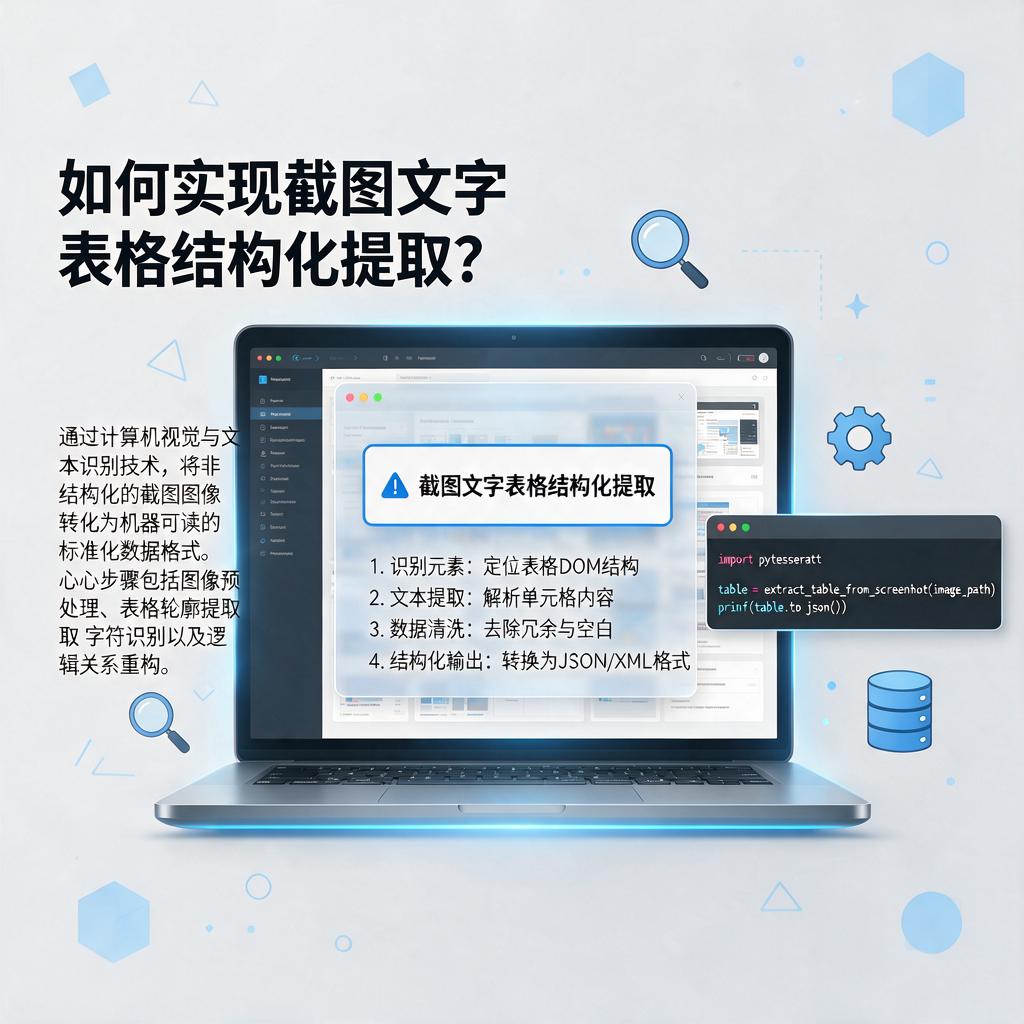
截图文字表格结构化提取
想要实现截图文字表格的结构化提取,其实并不复杂,即使你是完全的小白,也能一步步学会操作。下面我会用最简单易懂的方式教你如何完成这个任务。
首先,你需要准备一个能识别图片中文字的工具,比如常用的OCR软件。这类软件有很多,像QQ自带的截图识字功能、百度OCR、腾讯OCR,或者一些手机端的APP,比如“白描”等。这些工具都能很好地识别图片中的文字内容。打开你选择的工具,把截图上传或者粘贴进去,然后使用文字识别功能,将截图中的文字提取出来。提取完成后,你会得到一段纯文本内容,可能包含表格的行和列信息,但这时候它们还不是结构化的表格形式。
接下来,你需要整理提取出来的文字。把表格的标题行单独列出来,比如“姓名”“年龄”“性别”这些列名。然后看每一行的数据,比如“张三 25 男”,你需要按照列名对应的顺序,把这些数据分开。如果工具提取出来的文字有换行符,那会方便很多,因为每一行数据通常都会单独占一行。如果没有换行符,你可以手动在每行数据之间添加换行,方便后续处理。
整理好数据后,就可以把它们转换成结构化的表格了。如果你使用的是Excel或者WPS表格这类电子表格软件,直接把整理好的数据复制粘贴进去就行。第一行是标题行,下面的每一行对应表格的一行数据。粘贴完成后,检查一下数据是否对齐,有没有错位的情况。如果有,手动调整一下单元格的位置,确保每一列的数据都正确对应。
如果你不想用电子表格软件,也可以用Markdown格式来创建表格。Markdown是一种轻量级的标记语言,用简单的符号就能表示表格。比如,一个三列两行的表格可以这样写:
| 姓名 | 年龄 | 性别 |
|------|------|------|
| 张三 | 25   | 男   |
第一行是表头,用竖线和短横线组成,短横线的数量至少三个,用来分隔表头和内容。第二行开始是表格的数据,每一行用竖线分隔每一列的内容。写完后,你可以把这段Markdown代码粘贴到支持Markdown渲染的平台,比如一些笔记软件、论坛或者GitHub,就能看到结构化的表格了。
还有一种情况,如果截图中的表格比较复杂,比如有合并单元格或者多级表头,这时候OCR工具可能无法完美识别。遇到这种情况,你可以先尽量提取出文字,然后手动调整表格结构。比如,把合并的单元格拆分成多个单元格,或者把多级表头拆分成多行表头。虽然需要多花点时间,但这样能保证表格的准确性。
最后,检查一下提取的表格是否完整,数据是否正确。比如,看看有没有漏掉某一行或者某一列的数据,数字和文字是否对应正确。如果发现问题,回到之前的步骤,重新提取或者调整数据。完成这些后,你就成功把截图中的文字表格提取成结构化的表格了。
整个过程虽然看起来有点多,但实际操作起来并不难。只要按照步骤一步步来,即使你是完全的小白,也能轻松完成截图文字表格的结构化提取。希望这些方法能帮到你!
截图文字表格结构化提取的方法有哪些?
想要将截图中的文字表格进行结构化提取,有多种方法可以尝试,下面会详细介绍每一种方法,帮助你轻松完成这项任务。
第一种方法是使用OCR识别软件。OCR,全称Optical Character Recognition,即光学字符识别,它能够将图片中的文字转换成可编辑的文本。你可以选择一些知名的OCR软件,比如Adobe Acrobat、ABBYY FineReader或者在线的OCR工具如iLovePDF等。使用这些工具时,只需将截图上传,选择识别区域,软件就会自动将图片中的文字提取出来。提取后的文字可以复制到Excel或其他表格处理软件中,进行进一步的整理和结构化。
第二种方法是利用手机上的OCR应用。现在很多手机都自带了OCR功能,或者你可以从应用商店下载一些OCR应用,比如扫描全能王、白描等。这些应用通常操作简便,只需打开应用,对准截图进行拍照或上传截图,应用就会自动识别文字。识别完成后,你可以选择将文字导出为文本文件,或者直接分享到支持表格处理的软件中。
第三种方法是借助专业的表格识别工具。这类工具专门针对表格结构进行识别,能够更准确地提取表格中的行列信息。你可以搜索一些在线的表格识别工具,比如SmallPDF、Table Extractor等。使用这些工具时,同样需要上传截图,工具会自动分析表格结构,并将识别结果以Excel或其他表格格式导出。
第四种方法,如果你有一定的编程基础,还可以考虑使用Python等编程语言结合OCR库进行自定义开发。Python中有多个OCR库可供选择,比如Tesseract、EasyOCR等。通过编写脚本,你可以实现自动化的截图文字表格提取过程,并根据需要调整识别参数和输出格式。这种方法虽然需要一定的技术门槛,但能够实现高度定制化的需求。
无论选择哪种方法,提取完成后都需要对结果进行核对和修正。因为OCR识别并非百分之百准确,特别是遇到字体模糊、背景复杂或表格线条不清晰的情况时,识别错误的可能性会增加。所以,在提取完成后,务必仔细检查每一行每一列的数据,确保提取结果的准确性。
希望这些方法能够帮助你轻松完成截图文字表格的结构化提取任务。如果还有其他问题或需要进一步的帮助,随时欢迎提问哦!
截图文字表格结构化提取工具推荐?
如果你需要从截图里提取文字并整理成表格结构,推荐试试以下几款工具,它们操作简单且功能实用,特别适合新手使用。
第一个推荐的是 ABBYY Screenshot Reader。这款工具能精准识别截图中的文字,无论是图片还是PDF截图,都能快速提取出来。它支持将提取的文字直接导出为Excel表格,方便后续编辑整理。操作起来非常简单,只需打开软件,选择截图区域,点击识别按钮,就能轻松完成文字提取和表格转换。
第二个推荐的是 Snagit。虽然它主要是一款截图工具,但内置了强大的OCR文字识别功能。用Snagit截取包含表格的图片后,可以直接使用OCR功能提取文字,然后粘贴到Excel或其他表格处理软件中。它的界面友好,操作直观,即使是初次使用也能快速上手。
第三个推荐的是 Online OCR。这是一个在线工具,无需安装软件,直接在网页上就能完成截图文字的提取和表格转换。上传截图后,选择输出格式为Excel,就能快速得到结构化的表格数据。它支持多种语言识别,包括中文,非常适合处理多语言截图。
第四个推荐的是 Adobe Acrobat Pro DC。如果你经常需要处理PDF截图,这款工具会是个不错的选择。它不仅能识别PDF中的文字,还能将表格结构完整保留下来。导入PDF截图后,使用导出功能选择Excel格式,就能轻松得到可编辑的表格文件。
这些工具各有特点,你可以根据自己的需求选择最适合的一款。无论是处理工作文档还是学习资料,它们都能帮你高效完成截图文字的表格化提取,让数据整理变得更加轻松简单。
截图文字表格结构化提取的准确率如何?
截图文字表格结构化提取的准确率是一个受到多种因素影响的指标,不能简单地给出一个固定的数值。不过,可以详细分析影响准确率的关键因素,以及如何提高准确率。
影响截图文字表格结构化提取准确率的因素有很多。图像质量是基础因素,如果截图模糊、分辨率低或者存在严重的噪点,那么文字识别的准确率就会大幅下降。表格布局的复杂性也会影响提取效果,如果表格中存在合并单元格、嵌套表格或者不规则的边框,都会增加结构化提取的难度。文字本身的特性,比如字体大小、颜色、是否倾斜等,也会对识别结果产生影响。
为了提高截图文字表格结构化提取的准确率,可以采取一系列措施。选择高质量的截图工具,确保截图清晰、无模糊。在截图时尽量保持表格的完整性,避免截取到不完整的表格部分。对截图进行预处理,比如调整亮度、对比度,去除噪点等,以改善图像质量。选择专业的表格结构化提取工具或软件,这些工具通常具备更先进的文字识别技术和表格解析算法,能够更准确地提取表格信息。
在实际应用中,还可以通过人工校验和修正来提高准确率。即使使用最先进的工具和技术,也难免会出现一些识别错误或解析不准确的情况。在提取完表格信息后,进行人工校验和修正是非常必要的。可以逐行逐列检查提取结果,确保数据的准确性和完整性。
截图文字表格结构化提取的准确率并非固定不变,而是受到多种因素的影响。通过选择高质量的截图工具、进行预处理、使用专业的提取工具以及人工校验和修正等措施,可以有效提高提取的准确率。