如何实现截图文字文档的智能分类?
截图文字文档智能分类
想要对截图里的文字文档进行智能分类,可以按照下面这些详细步骤来操作,就算你是完全不懂技术的小白也能轻松上手。
第一步,准备工具。你需要用到两个关键工具,一个是能识别图片中文字的 OCR 工具,另一个是能进行文档分类的工具。对于 OCR 工具,现在市面上有很多免费的软件,比如百度 OCR、腾讯 OCR 等,它们都有网页版或者客户端版本,你可以根据自己的需求选择。以百度 OCR 为例,你可以在百度搜索“百度 OCR”,进入它的官方网站,然后按照提示注册一个账号,这样就能使用它的文字识别功能了。对于文档分类工具,你可以使用一些专业的文本分类软件,像 RapidMiner、Weka 等,不过这些软件可能对新手来说有点复杂。还有一个更简单的方法,就是使用一些在线的文本分类平台,比如 MonkeyLearn,它提供了简单易用的界面,不需要你有太多的技术知识就能操作。
第二步,进行文字识别。打开你选好的 OCR 工具,以百度 OCR 为例,在它的网页版中找到“图片文字识别”功能入口。点击上传按钮,把你想要分类的截图上传上去。上传成功后,点击识别按钮,等待一会儿,OCR 工具就会把图片中的文字提取出来,并且显示在页面上。你可以检查一下识别结果是否准确,如果有错误的地方,可以手动进行修改。修改完成后,把识别出来的文字复制下来,保存到一个文本文件中,比如 TXT 格式的文件。
第三步,准备分类模型。如果你使用的是在线的文本分类平台,比如 MonkeyLearn,你需要先注册一个账号并登录。进入平台后,创建一个新的分类模型。在创建模型的过程中,你需要定义分类的类别,比如你可以根据文档的内容把类别分为“新闻”“科技”“娱乐”“体育”等。定义好类别后,你需要准备一些已经分类好的文本样本作为训练数据,把这些样本上传到平台中,让模型学习不同类别的特征。训练数据越多,模型的分类准确率通常会越高。如果你不想自己准备训练数据,有些平台也提供了一些现成的分类模型,你可以直接使用。
第四步,进行文档分类。把之前保存好的包含截图文字的文本文件导入到文本分类平台中。如果你的模型已经训练好了,点击分类按钮,平台就会自动对文本进行分类,并且把分类结果显示出来。你可以查看每个文档被分到了哪个类别,如果有分类不准确的情况,你可以对模型进行进一步的调整和优化,比如增加更多的训练数据或者修改分类规则。
第五步,整理分类结果。分类完成后,你可以把分类结果整理到一个表格中,方便查看和管理。表格可以包含文档名称、分类类别等信息。你还可以根据分类结果对文档进行进一步的整理,比如把同一类别的文档放到同一个文件夹中。
通过以上这些步骤,你就可以轻松地对截图里的文字文档进行智能分类了。虽然一开始可能会觉得有点复杂,但只要你按照步骤一步一步来操作,多尝试几次,很快就能掌握这个技能。希望这些方法能帮助你解决文档分类的问题,让你的工作更加高效。
截图文字文档智能分类的方法有哪些?
截图文字文档智能分类的方法有很多,以下从基础到进阶详细介绍几种常用且实用的方法,帮助你轻松实现文档分类管理。
第一种方法是基于关键词匹配的分类方法。这种方法适合处理内容主题明确的截图文档。你需要先确定每个分类的关键词,比如“合同”“发票”“会议纪要”等。然后使用OCR工具将截图中的文字提取出来,接着通过编程或文档处理工具编写规则,检查提取的文字中是否包含特定关键词。如果包含,就将文档归类到对应的分类中。例如,提取的文字中有“租赁合同”字样,就归类到“合同”文件夹。这种方法实现简单,适合分类规则明确、关键词差异大的场景。
第二种方法是利用机器学习算法进行分类。如果截图文档内容复杂、关键词不明显,或者分类规则难以用简单关键词描述,机器学习是更好的选择。首先需要准备大量已分类的截图文档作为训练数据,这些文档要覆盖各种可能的情况。然后选择合适的机器学习模型,比如朴素贝叶斯、支持向量机或深度学习模型。将训练数据输入模型进行训练,让模型学习文档特征与分类之间的关系。训练完成后,用OCR提取新截图的文字,输入模型即可得到分类结果。这种方法需要一定编程基础,但分类准确率高,能适应复杂场景。
第三种方法是结合图像特征与文字内容的混合分类方法。有些截图不仅包含文字,还有特定布局、颜色或图标等图像特征。比如发票截图可能有固定的表格布局和红色印章。可以先提取图像特征,如颜色分布、形状检测,再结合OCR提取的文字内容,共同作为分类依据。这种方法能更全面地利用截图信息,提高分类准确性,尤其适合图像特征明显的文档分类。
第四种方法是使用现成的智能文档分类工具。如果你不想自己开发分类系统,可以选择市面上成熟的工具,如百度OCR、腾讯云OCR等。这些工具通常提供OCR文字识别和智能分类功能,支持自定义分类规则或使用预训练模型。你只需上传截图,工具会自动识别文字并分类,操作简单,适合非技术用户或快速部署场景。
第五种方法是基于用户反馈的迭代优化方法。无论使用哪种分类方法,初始分类可能不够准确。可以通过收集用户反馈来优化分类模型。比如让用户手动调整分类结果,将调整后的数据加入训练集重新训练模型。持续迭代后,分类准确率会逐步提高,适应更多变化场景。
实际应用中,可以根据需求选择单一方法或组合使用。比如先用OCR提取文字,再用关键词匹配快速分类简单文档,复杂文档用机器学习模型处理。定期更新关键词或训练数据,保持分类系统的有效性。希望这些方法能帮助你高效管理截图文字文档!
截图文字文档智能分类工具推荐?
想找能对截图文字文档进行智能分类的工具,下面为你推荐几款实用好用的,它们各有特点,能满足不同场景需求。
第一款是“白描”。这是一款功能强大的文字识别与文档处理工具,对截图文字的识别准确率相当高。它运用先进的 OCR 技术,能快速精准地把截图里的文字提取出来。在智能分类方面,它可以根据文字内容进行自动归类。比如,你有很多包含合同信息的截图,它能识别出合同相关的关键词,像“合同”“甲方”“乙方”等,然后把这些截图自动归到“合同类”文件夹。操作起来也很简单,打开软件后,选择截图识别功能,上传截图,识别完成后,在设置里开启智能分类选项,它就会自动完成分类工作。而且,白描支持多种语言识别,不管是中文、英文还是其他常见语言,都能轻松应对。它还有批量处理功能,如果你有大量截图需要识别和分类,一次性上传,它能快速完成全部任务,大大节省时间和精力。
第二款推荐“扫描全能王”。它是一款综合性的文档扫描与管理工具,在截图文字文档分类上表现出色。它具备高精度的文字识别能力,能将截图中的文字清晰准确地提取出来。其智能分类功能十分智能,它会分析文字内容,依据语义和关键词进行分类。例如,对于包含会议记录的截图,它能识别出“会议”“时间”“地点”“议题”等关键词,将这些截图归到“会议记录类”。扫描全能王还支持自定义分类规则,你可以根据自己的需求设置特定的关键词或分类标准,让分类更加精准符合你的习惯。它还有云存储功能,分类好的文档可以自动同步到云端,方便你在不同设备上随时查看和管理,不用担心数据丢失。同时,它的操作界面简洁易懂,即使是初次使用的小白也能快速上手。
第三款是“ABBYY FineReader”。这是一款专业的 OCR 软件,在文字识别和文档处理领域有着很高的声誉。它对截图文字的识别效果非常好,能保留原始文档的格式和排版,让识别后的文字看起来和原截图几乎一样。在智能分类方面,它拥有强大的算法,可以深入分析文字内容,进行细致的分类。比如,对于科研类的截图文档,它能识别出研究领域、实验方法、研究结果等关键信息,将截图准确地归到相应的科研类别中。ABBYY FineReader 还支持对分类后的文档进行进一步编辑和处理,你可以对识别错误的文字进行修改,调整文档格式等。虽然它的功能比较专业,但操作并不复杂,软件提供了详细的操作指南和教程,帮助你快速掌握使用方法。
以上三款工具都能实现对截图文字文档的智能分类,你可以根据自己的具体需求和使用习惯选择适合自己的工具。希望这些推荐能帮助你高效地管理截图文字文档。
截图文字文档智能分类的准确率如何?
截图文字文档智能分类的准确率是一个受多种因素影响的综合结果,具体表现需要结合技术实现、数据质量、场景需求来分析。以下从核心影响因素、常见准确率范围、提升方法三个维度展开说明,帮助你全面理解这一技术的实际效果。
技术实现方式直接影响准确率。目前主流的截图文字分类技术主要依赖两种路径:一是基于OCR(光学字符识别)提取文字后,用自然语言处理(NLP)模型进行分类;二是直接对截图图像进行端到端分类(跳过文字提取步骤)。前者因需经过OCR转换,若截图中的文字存在模糊、倾斜、手写体或复杂排版(如表格、多栏文本),OCR的识别错误会直接传递到分类环节,导致准确率下降,通常在80%-90%之间;后者通过卷积神经网络(CNN)等图像模型直接分析像素特征,对清晰截图的分类准确率可达90%以上,但对文字内容本身的语义理解较弱,若截图包含大量图形或非标准布局,准确率可能降至75%-85%。
数据质量是准确率的关键基础。训练分类模型需要大量标注好的截图样本,若数据覆盖的场景不足(例如只训练了办公文档截图,未包含社交媒体截图、设计稿截图等),模型在遇到新类型截图时会出现“没见过所以分不准”的情况。此外,标注的准确性也至关重要——如果人工标注时存在错误(比如将“合同”误标为“报告”),模型学习到的规律就会偏差,最终准确率可能低于80%。优质数据通常需要覆盖至少5000-10000个样本,且包含20种以上常见截图类型,才能让模型达到90%左右的准确率。
场景需求决定了准确率的“合格线”。如果是企业内部文档管理(如自动将截图归档到“财务”“人事”“项目”等固定类别),对准确率的要求较高(建议95%以上),因为错误分类可能导致重要文件丢失或泄露;如果是社交媒体内容分析(如区分用户上传的截图是“聊天记录”“商品图片”还是“新闻截图”),对准确率的要求可适当放宽(85%-90%即可),因为这类场景更关注趋势而非单条数据的绝对正确。实际应用中,可通过“人工复核+模型迭代”的组合提升效果:先让模型处理大部分简单截图,再由人工检查可疑结果,并将错误案例反馈给模型重新训练,逐步将准确率提升至目标值。
提升准确率的实操建议:优先选择支持“OCR+NLP”双路径融合的分类工具(既能利用文字语义,又能结合图像特征);训练数据时确保包含目标场景的所有常见截图类型(如包含不同分辨率、不同背景、不同文字大小的截图);定期用新数据更新模型(建议每1-2周更新一次,避免模型“过时”);对准确率要求高的场景,可设置“低置信度阈值”(比如模型对某张截图的分类置信度低于90%时,自动标记为“需人工审核”),避免错误自动生效。
总结来看,截图文字文档智能分类的准确率通常在75%-95%之间,具体数值取决于技术方案、数据质量和场景需求。通过优化技术路径、完善训练数据、结合人工复核,可以逐步将准确率提升到满足业务需求的水平。如果是初次尝试,建议先在小范围场景(如固定类型的办公文档)测试,再逐步扩展到复杂场景,这样能更高效地控制风险。
如何实现截图文字文档的智能分类?
想要实现截图文字文档的智能分类,可以按照以下步骤来操作,即使你是小白也能轻松上手哦!
第一步,准备工具与环境。需要安装一些图像处理和文字识别的软件库,比如Python中的Pillow库用于图像处理,Tesseract OCR用于文字识别,还有scikit-learn或TensorFlow这样的机器学习库用于分类。别担心,这些库都有详细的安装教程,跟着步骤一步步来就行。
第二步,图像预处理。截图可能包含各种背景、光线和角度,所以得先对图像进行预处理,让文字更清晰。可以使用Pillow库来调整图像的亮度、对比度,或者进行灰度化处理。如果图像有倾斜,还可以进行旋转校正。这些操作都能让后续的文字识别更准确。
第三步,文字识别。使用Tesseract OCR库来识别图像中的文字。这个库支持多种语言,包括中文,所以不用担心文字识别的问题。识别出来的文字会以文本形式输出,接下来就可以对这些文本进行处理了。
第四步,特征提取。为了对文档进行分类,需要从文本中提取一些特征。比如,可以统计文本中的关键词出现频率,或者使用更高级的自然语言处理技术来提取文本的主题、情感等特征。这些特征将作为分类的依据。
第五步,构建分类模型。使用scikit-learn或TensorFlow这样的机器学习库来构建分类模型。可以选择适合的分类算法,比如决策树、支持向量机或神经网络。将提取的特征输入到模型中,让模型学习如何根据这些特征对文档进行分类。
第六步,训练与评估模型。使用一部分已知类别的文档来训练模型,让模型学习分类的规则。然后,用另一部分文档来评估模型的性能,看看它能否准确地对新文档进行分类。如果性能不满意,可以调整模型的参数或尝试其他分类算法。
第七步,应用模型进行分类。当模型训练好了并且性能满意后,就可以用它来对新的截图文字文档进行分类了。只需将文档进行预处理、文字识别、特征提取,然后输入到模型中,模型就会输出文档的类别。
最后,持续优化与迭代。智能分类是一个持续优化的过程。随着新数据的加入和模型性能的评估,可以不断调整模型的参数或改进特征提取的方法,以提高分类的准确性和效率。
按照这些步骤来操作,你就能实现截图文字文档的智能分类啦!希望这个解答能帮到你,如果有任何问题或需要进一步的帮助,随时告诉我哦!
截图文字文档智能分类的原理是什么?
截图文字文档智能分类的原理主要依赖于图像识别技术和自然语言处理技术的结合,通过多个步骤实现对文档的自动分类。下面详细介绍这一过程,帮助你理解其工作机制。
首先,系统会对输入的截图进行图像预处理。这一步的目的是提高图像质量,使后续的识别更加准确。预处理可能包括去噪、调整对比度、增强文字边缘等操作。这些操作确保图像中的文字清晰可辨,为后续的识别打下基础。
接下来,系统会使用光学字符识别(OCR)技术将图像中的文字提取出来。OCR技术通过分析图像中的像素分布,识别出每个字符的形状,并将其转换为计算机可编辑的文本格式。这一步是整个分类过程的关键,因为只有将图像中的文字准确提取出来,才能进行后续的分析和分类。
提取出文字后,系统会利用自然语言处理技术对文本内容进行分析。这包括分词、词性标注、命名实体识别等步骤,目的是将文本转化为计算机能够理解的结构化数据。通过这些分析,系统可以理解文本的主题、情感、关键词等信息。
然后,系统会根据预设的分类规则或机器学习模型对文本进行分类。分类规则可以基于关键词匹配、主题模型等方法制定。例如,如果文档中频繁出现“合同”、“甲方”、“乙方”等关键词,系统可能会将其归类为“合同文档”。机器学习模型则通过训练大量已标注的文档数据,学习如何根据文本特征自动分类。这些模型可以不断优化,提高分类的准确性。
最后,系统会将分类结果返回给用户。用户可以根据分类结果对文档进行整理、存储或进一步处理。智能分类大大提高了文档管理的效率,尤其适用于处理大量截图文字文档的场景。
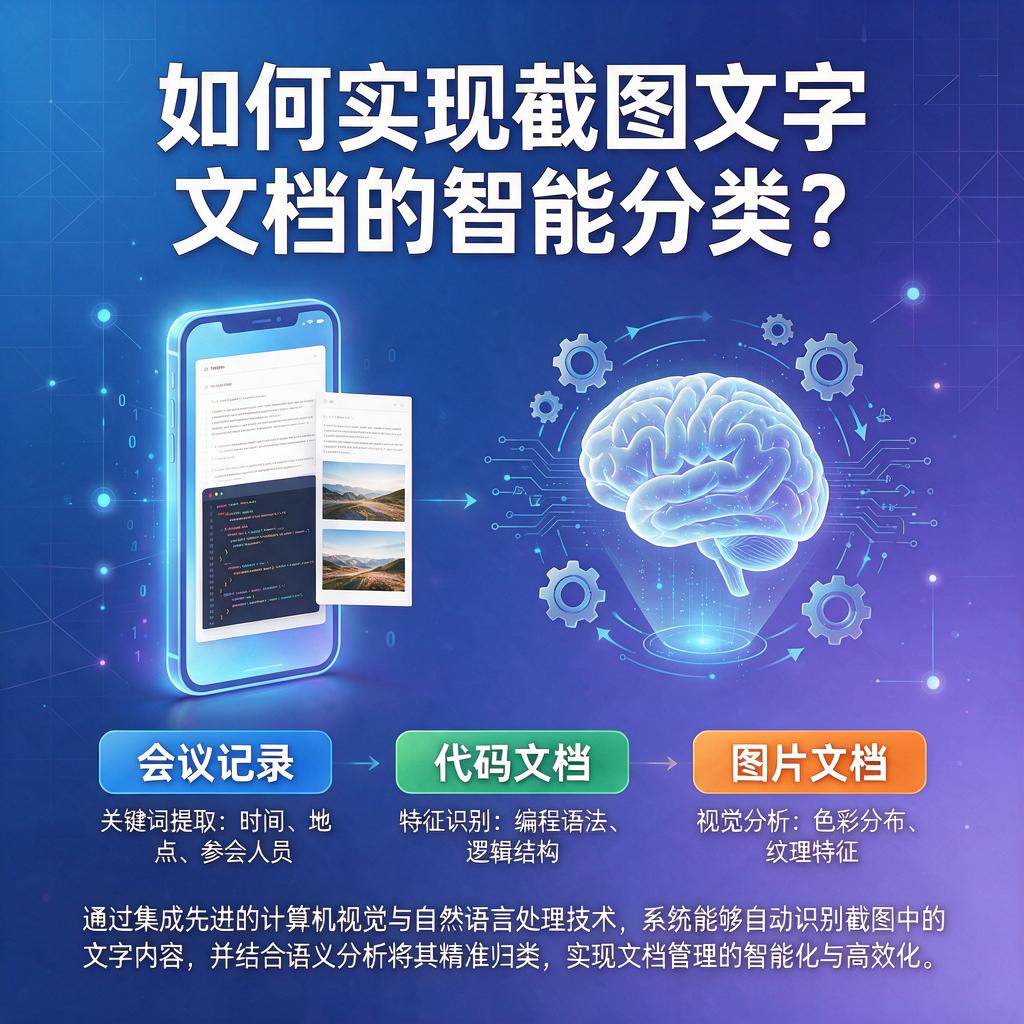
整个过程中,图像识别技术和自然语言处理技术的紧密结合是实现智能分类的核心。随着技术的不断发展,截图文字文档智能分类的准确性和效率还将不断提升,为用户带来更加便捷的使用体验。