Snipaste如何处理文字依存关系?
Snipaste文字依存关系
Snipaste 是一款功能强大的截图工具,支持对截图中的文字进行识别和操作。关于“文字依存关系”这一功能,它主要指的是在截图后对文字区域进行精准定位、提取或标注时,文字与周围元素之间的关联性处理。以下是详细操作指南,帮助你快速掌握这一功能,即使你是新手也能轻松上手。
首先,安装并打开 Snipaste 软件。启动后,默认会进入截图模式,此时按下快捷键(通常是 F1)即可开始截图。在截图过程中,将鼠标移动到包含文字的区域,Snipaste 会自动识别文字边界,并以半透明高亮显示。这一步是建立文字依存关系的基础,确保软件能准确捕捉文字位置。
接下来,调整文字识别范围。如果自动识别的区域不够精准,可以手动拖动截图框的边缘或角落,微调文字区域的边界。例如,若截图中有两段文字,但只需提取其中一段,可通过缩小截图框来排除无关内容。这一操作能强化文字与背景的依存关系,避免干扰信息。
完成截图后,进入编辑界面。此时,你可以对文字区域进行进一步处理。若需提取文字,点击工具栏中的“文字识别”按钮(通常显示为“OCR”图标),Snipaste 会将识别到的文字复制到剪贴板,可直接粘贴到文档或输入框中。若需标注文字,可使用画笔、箭头或文本框工具,在文字附近添加说明或高亮。这些操作能直观展示文字与其他元素的依存关系,例如用箭头指向文字解释其含义。
此外,Snipaste 支持保存文字依存关系的截图。编辑完成后,点击“保存”按钮,选择格式(如 PNG 或 JPEG)和存储路径。保存的截图会保留所有标注和文字识别信息,方便后续查看或分享。若需重复使用同一区域的文字,可开启“贴图”功能(默认快捷键 F3),将截图固定在屏幕上,随时调用或修改。
常见问题解答:若文字识别不准确,可能是字体过小或背景复杂导致。可尝试放大截图区域、调整对比度,或更换更清晰的截图源。若标注工具遮挡文字,可调整图层顺序或使用半透明画笔。通过这些方法,你能更高效地利用 Snipaste 处理文字依存关系,提升工作或学习效率。
总结来说,Snipaste 的文字依存关系功能通过精准识别、灵活编辑和便捷保存,帮助用户高效处理截图中的文字信息。无论是提取、标注还是分享,都能轻松完成。按照上述步骤操作,即使初次使用也能快速上手,享受这一工具带来的便利。
Snipaste文字依存关系是什么?
Snipaste是一款功能强大的截图与贴图软件,它不仅仅是一个简单的截图工具,还提供了丰富的标注和编辑功能。关于“Snipaste文字依存关系”,这里可能指的是在Snipaste软件中,文字标注与其他截图元素之间的关联和依赖关系。
在Snipaste中,当用户进行截图后,可以对截图进行各种标注,包括添加文字。这里的文字依存关系主要体现在以下几个方面:
文字与截图的依存:文字标注是依附于截图之上的,没有截图,就无法进行文字标注。文字标注的内容通常是对截图内容的解释、说明或补充,因此,文字与截图之间存在着紧密的依存关系。
文字与其他标注元素的依存:除了文字标注外,Snipaste还支持添加箭头、形状、马赛克等其他标注元素。这些元素与文字标注可以相互配合,共同构成对截图的完整标注。例如,可以用箭头指向截图中的某个部分,并在旁边添加文字说明。这种情况下,文字与其他标注元素之间也存在着依存关系。
文字属性的依存:在Snipaste中,用户可以对文字标注的字体、大小、颜色等属性进行调整。这些属性设置是依存于文字标注本身的,不同的文字标注可以有不同的属性设置。这些属性设置能够帮助用户更好地表达标注意图,提高标注的清晰度和可读性。
总的来说,Snipaste中的文字依存关系主要体现在文字与截图的依存、文字与其他标注元素的依存以及文字属性的依存上。这些依存关系共同构成了Snipaste截图标注的完整体系,使得用户能够更加方便、灵活地进行截图和标注操作。无论是对于工作学习中的资料整理,还是对于日常生活中的信息分享,Snipaste都能提供有力的支持。
Snipaste如何处理文字依存关系?
Snipaste是一款功能强大的截图和贴图工具,它本身并不直接处理文字的依存关系,因为它的主要功能集中在截图、标注以及贴图方面。不过,如果需要在截图过程中处理文字的依存关系,或者对截图中的文字进行后续分析,可以结合其他工具或方法来实现。下面详细介绍如何结合Snipaste和其他工具来处理文字依存关系。
首先,使用Snipaste进行截图。打开Snipaste,按下截图快捷键(默认是F1,也可以自定义),然后用鼠标框选需要截取的区域。截图完成后,可以对截图进行简单的标注,比如添加箭头、文字说明等,这些标注可以帮助理解文字之间的关系。
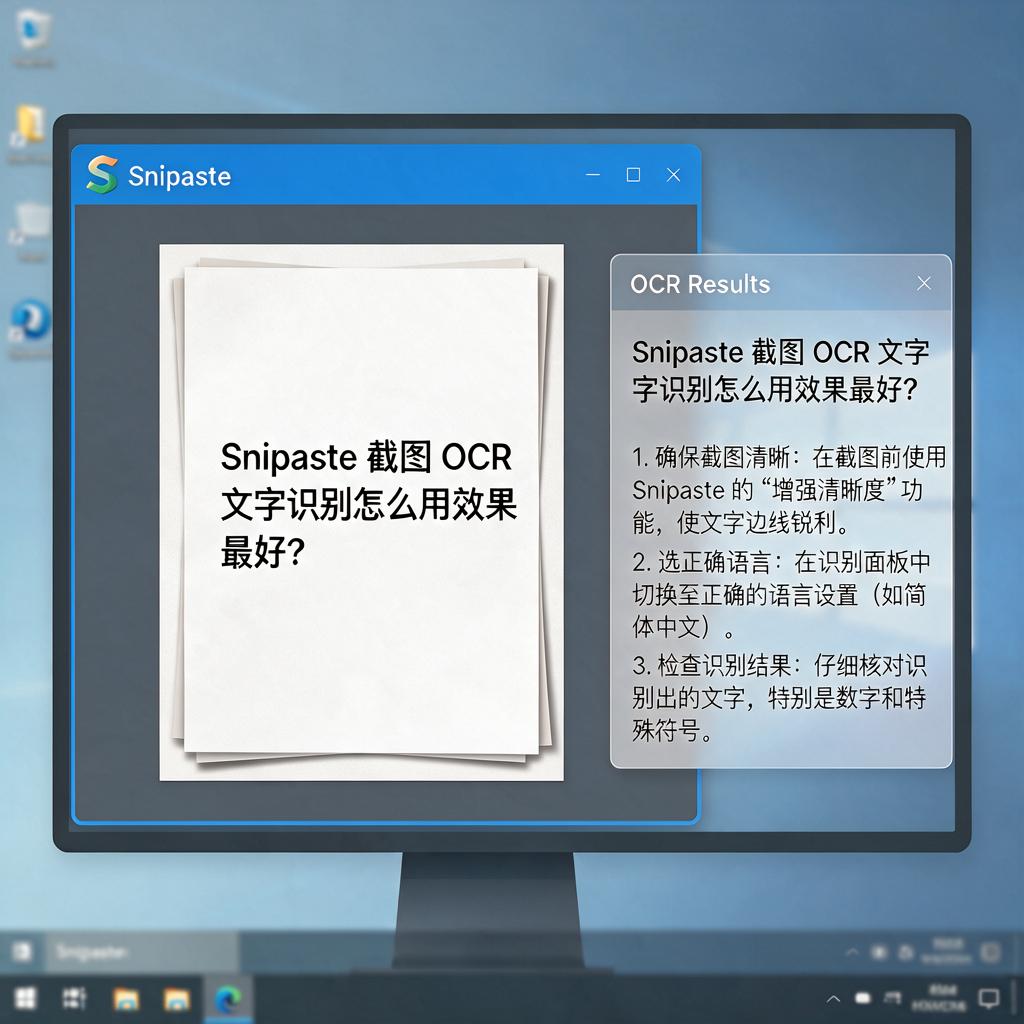
接下来,如果需要对截图中的文字进行依存关系分析,需要将截图中的文字提取出来。可以使用OCR(光学字符识别)工具,比如百度OCR、腾讯OCR等,将截图中的文字识别并转换为可编辑的文本格式。将截图导入OCR工具后,选择识别区域,工具会自动将文字识别出来,并生成文本文件。
得到文本文件后,可以使用自然语言处理(NLP)工具来分析文字的依存关系。常用的NLP工具有Stanford CoreNLP、spaCy等。以Stanford CoreNLP为例,首先需要下载并安装该工具,然后按照其文档说明将文本输入到工具中进行分析。分析完成后,工具会生成依存关系树,展示每个词语之间的语法关系,比如主谓关系、动宾关系等。
如果不想使用复杂的NLP工具,也可以手动分析文字的依存关系。将提取出来的文字逐句分析,确定每个词语在句子中的角色,比如主语、谓语、宾语等,然后根据这些角色确定词语之间的依存关系。这种方法虽然耗时,但对于简单的句子或少量文字是可行的。
另外,如果截图中的文字是代码或特定格式的文本,依存关系的处理方式会有所不同。对于代码,可以使用代码分析工具来理解变量、函数之间的调用关系;对于特定格式的文本,比如XML、JSON等,可以根据其结构特点来解析文字之间的依存关系。
总之,虽然Snipaste本身不直接处理文字的依存关系,但可以通过截图、文字提取和NLP分析等步骤,结合其他工具来实现这一目标。希望这些方法能帮助你更好地处理文字依存关系,提升工作效率。
Snipaste文字依存关系应用场景?
Snipaste是一款功能强大的截图工具,它不仅可以快速截图,还支持对截图中的文字进行提取和编辑,在文字依存关系分析方面有着不少实用的应用场景。下面就详细介绍几个常见的应用场景,即便你是刚接触Snipaste的小白也能轻松理解。
在学术研究场景中,文字依存关系分析对于理解文献内容至关重要。当你在阅读一篇复杂的学术论文时,里面有很多专业术语和复杂句子结构。使用Snipaste,你可以精准地截取包含关键信息的段落,然后提取其中的文字。通过分析这些文字的依存关系,比如哪些词是修饰关系、哪些是主谓关系等,能更清晰地把握句子核心意思,快速定位到论文的关键论点和论据,提高阅读效率,为后续的学术研究和论文撰写提供有力支持。例如,在研究医学文献时,对于一些描述疾病症状和治疗方法的句子,分析文字依存关系能让你准确理解各种症状与疾病之间的关联,以及不同治疗方法所针对的具体情况。
在语言学习场景里,文字依存关系分析有助于深入理解语法结构。学习一门新语言时,语法规则往往是难点。使用Snipaste截取教材或练习中的句子,提取文字后分析依存关系,能直观地看到每个词在句子中的作用和相互关系。比如在学习英语时,对于一些长难句,通过分析可以明确主语、谓语、宾语等主要成分,以及各种修饰成分,从而更好地掌握句子结构,提高语言理解和运用能力。对于学习中文的外国学习者来说,分析汉字之间的依存关系,能帮助他们理解词语的搭配和句子的逻辑,避免出现语法错误。
在信息整理场景中,文字依存关系分析可以优化信息提取和归纳。当你需要从大量文本资料中提取关键信息并进行整理时,Snipaste能发挥大作用。先截取相关文本,提取文字后分析依存关系,找出句子中的核心信息和关联信息。这样在整理信息时,就能更有条理地将相关内容归类,去除冗余信息,提高信息整理的效率和质量。比如在整理新闻报道时,分析文字依存关系可以快速确定事件主体、发生时间、地点等关键要素,将多篇新闻中关于同一事件的信息准确整合。
在软件开发场景中,文字依存关系分析可辅助代码注释理解。软件代码通常包含大量注释,这些注释对于理解代码功能和逻辑很重要。使用Snipaste截取代码注释部分,提取文字后分析依存关系,能帮助开发人员更好地理解注释所描述的代码功能和实现逻辑。特别是对于一些复杂的算法或模块,通过分析注释文字的依存关系,可以更清晰地把握代码的整体架构和各个部分之间的关系,提高代码阅读和维护的效率。
在文本校对场景里,文字依存关系分析有助于发现潜在的语法和逻辑错误。校对文本时,利用Snipaste截取文本内容,提取文字后分析依存关系。如果发现某些词语之间的依存关系不符合正常语法规则或逻辑,就可能存在错误。比如在一个句子中,主语和谓语的搭配不合理,通过分析依存关系就能快速发现并修正,提高文本的质量和准确性。
Snipaste在文字依存关系分析方面有着广泛的应用场景,无论是学术研究、语言学习、信息整理,还是软件开发和文本校对,都能借助它的截图和文字提取功能,结合文字依存关系分析,让工作和学习更加高效、准确。
Snipaste文字依存关系提取方法?
想要使用Snipaste来进行文字依存关系提取,其实需要明确一点:Snipaste本身是一个功能强大的截图和贴图工具,并不直接提供文字依存关系提取的功能。不过,别担心,我们可以通过结合其他工具或方法来实现这一需求。下面,我会一步步详细介绍如何操作,即使你是小白也能轻松上手。
首先,需要准备的工具除了Snipaste外,还需要一个能够进行文字识别(OCR)的软件或在线服务,以及一个能够分析文字依存关系的自然语言处理(NLP)工具或库。文字识别工具可以将图片中的文字转换成可编辑的文本格式,而NLP工具则能分析这些文本中词语之间的依存关系。
步骤一:使用Snipaste截图 打开你想要提取文字依存关系的界面或文档,使用Snipaste的截图功能,框选住包含目标文字的区域,然后保存为图片文件。这一步很简单,只需要熟悉Snipaste的基本操作即可。
步骤二:文字识别 接下来,使用OCR工具将上一步保存的图片转换成文本。市面上有很多OCR工具可供选择,比如Adobe Acrobat、百度OCR、腾讯OCR等,它们大多提供简单易用的界面和较高的识别准确率。将图片导入OCR工具,按照提示操作,很快就能得到转换后的文本文件。
步骤三:准备NLP分析环境 现在有了文本文件,接下来需要准备一个能够分析文字依存关系的NLP环境。如果你有一定的编程基础,可以使用Python等语言结合Stanford CoreNLP、spaCy等NLP库来实现。如果不太熟悉编程,也可以寻找一些在线的NLP分析平台,它们通常提供用户友好的界面和丰富的分析功能。
步骤四:进行依存关系分析 将上一步得到的文本导入到NLP分析环境中,选择依存关系分析功能。这一步会根据文本的语法结构,分析出每个词语与其他词语之间的依存关系,比如主谓关系、动宾关系等。分析完成后,你可以得到一个包含依存关系信息的输出文件或可视化图表。
步骤五:解读结果 最后,根据NLP工具的输出结果,解读文本中词语之间的依存关系。这一步可能需要一些语言学知识,但大多数NLP工具都会提供详细的解释和示例,帮助你理解分析结果。
通过以上步骤,虽然不能直接使用Snipaste进行文字依存关系提取,但结合OCR和NLP工具,我们依然能够达到目的。希望这个详细的操作流程能够帮助到你,让你轻松掌握文字依存关系提取的方法。