Snipaste如何生成并解读机器学习混淆矩阵?
Snipaste机器学习混淆矩阵
from sklearn.metrics import confusion_matrix y_true = [1, 0, 1, 1, 0] # 真实标签 y_pred = [1, 0, 0, 1, 0] # 预测标签 matrix = confusion_matrix(y_true, y_pred) print(matrix) # 输出:[[2 0] [1 2]](对应TN, FP; FN, TP)
Snipaste如何生成机器学习混淆矩阵?
from sklearn.metrics import confusion_matrix import numpy as np
y_true = np.array([0, 1, 0, 1, 1, 0]) y_pred = np.array([0, 1, 1, 1, 0, 0])
cm = confusion_matrix(y_true, y_pred)
print(cm)
机器学习混淆矩阵在Snipaste中的使用场景?
import seaborn as sns import matplotlib.pyplot as plt from sklearn.metrics import confusion_matrix
y_true = [0, 1, 0, 1, 1] y_pred = [0, 1, 1, 0, 1] cm = confusion_matrix(y_true, y_pred) plt.figure(figsize=(6, 4)) sns.heatmap(cm, annot=True, fmt='d', cmap='Blues') plt.xlabel('Predicted') plt.ylabel('True') plt.title('Confusion Matrix') plt.show()
Snipaste中机器学习混淆矩阵的解读方法?
在Snipaste这个软件里,虽然它本身不是专门用来做机器学习分析的工具,但我们可以借助它来截取并查看机器学习模型生成的混淆矩阵图片,然后对混淆矩阵进行解读。下面详细说说怎么解读机器学习中的混淆矩阵。
首先,得明白混淆矩阵长啥样。一个基本的二分类问题的混淆矩阵是一个2x2的表格。表格的行代表实际类别,列代表预测类别。假设我们有两个类别,正类(Positive)和负类(Negative),那么混淆矩阵的四个元素分别是:真正例(True Positive,TP),这是实际为正类且被预测为正类的样本数量;假正例(False Positive,FP),这是实际为负类但被预测为正类的样本数量;假反例(False Negative,FN),这是实际为正类但被预测为负类的样本数量;真反例(True Negative,TN),这是实际为负类且被预测为负类的样本数量。
有了这些基本概念,就可以开始解读混淆矩阵了。先看准确率(Accuracy),它表示模型预测正确的样本占总样本的比例。计算公式是(TP + TN)除以总样本数。准确率越高,说明模型整体上预测得越准。但准确率有个问题,如果数据不平衡,比如正类样本很少,负类样本很多,模型可能倾向于预测为负类,这样准确率可能看起来还不错,但实际上模型对正类的识别能力可能很差。
接着看精确率(Precision),它关注的是预测为正类的样本中,真正是正类的比例。计算公式是TP除以(TP + FP)。精确率越高,说明模型预测为正类的结果越可靠,误报(把负类预测成正类)的情况越少。
再看召回率(Recall),也叫查全率,它关注的是实际为正类的样本中,被模型正确预测出来的比例。计算公式是TP除以(TP + FN)。召回率越高,说明模型对正类的识别能力越强,漏报(把正类预测成负类)的情况越少。
还有一个重要的指标是F1值,它是精确率和召回率的调和平均数。计算公式是2乘以精确率乘以召回率,再除以(精确率 + 召回率)。F1值综合考虑了精确率和召回率,能更全面地评价模型的性能。
在实际应用中,要根据具体的需求来选择关注哪个指标。如果希望减少误报,就多关注精确率;如果希望减少漏报,就多关注召回率;如果希望两者都平衡,就看看F1值。
用Snipaste的时候,把混淆矩阵的图片截取下来,仔细查看每个元素的值,然后按照上面的方法计算各个指标,就能对模型的性能有一个清晰的认识啦。如果是多分类问题,混淆矩阵会更大,但原理是一样的,只是需要计算更多类别的指标,比如每个类别的精确率、召回率等。
用Snipaste绘制机器学习混淆矩阵的步骤?
import seaborn as sns import matplotlib.pyplot as plt from sklearn.metrics import confusion_matrix
cm = confusion_matrix(y_true, y_pred) plt.figure(figsize=(8,6)) sns.heatmap(cm, annot=True, fmt='d', cmap='Blues') plt.xlabel('Predicted labels') plt.ylabel('True labels') plt.savefig('confusion_matrix.png') # 保存图像
Snipaste与其他工具生成机器学习混淆矩阵对比?
在机器学习项目里,生成混淆矩阵是评估模型性能的关键步骤,它能直观呈现模型在分类任务中的表现。Snipaste是一款实用的截图工具,不过它本身并不具备生成机器学习混淆矩阵的功能。下面为你详细对比一些能生成机器学习混淆矩阵的工具与Snipaste在相关方面的差异。
先来说说专业的机器学习库Scikit - learn。Scikit - learn是Python中极为流行的机器学习库,它提供了丰富的函数来生成混淆矩阵。使用Scikit - learn生成混淆矩阵非常简单,只需导入相应的函数,然后将模型的预测结果和真实标签传入即可。例如,假设你已经有了真实标签y_true和预测结果y_pred,只需执行from sklearn.metrics import confusion_matrix; cm = confusion_matrix(y_true, y_pred),就能得到混淆矩阵。而且,Scikit - learn生成的混淆矩阵是数值形式的,方便进行后续的数据处理和分析,比如计算准确率、召回率等指标。与Snipaste相比,Snipaste没有这样的数据处理和分析能力,它主要用于截图和简单的图片标注。
再看看Matplotlib和Seaborn这两个可视化库。它们可以与Scikit - learn结合使用,将生成的数值混淆矩阵进行可视化展示。Matplotlib是Python中基础的绘图库,功能强大且灵活。使用Matplotlib绘制混淆矩阵,你可以自定义图表的各种元素,如颜色、标签、标题等。例如,你可以使用import matplotlib.pyplot as plt; import seaborn as sns; from sklearn.metrics import confusion_matrix; cm = confusion_matrix(y_true, y_pred); plt.figure(figsize=(8, 6)); sns.heatmap(cm, annot = True, fmt = 'd')来绘制一个带有数值标注的热力图形式的混淆矩阵。Seaborn则是基于Matplotlib的高级可视化库,它提供了更简洁的接口和更美观的默认样式。用Seaborn绘制混淆矩阵能让图表更加直观和易于理解。而Snipaste虽然能对图片进行标注,但无法像这两个库一样,根据数据自动生成具有丰富信息且美观的可视化混淆矩阵。
还有TensorFlow和PyTorch这两个深度学习框架。在它们进行模型训练和评估的过程中,也能方便地生成混淆矩阵。以TensorFlow为例,你可以使用tf.math.confusion_matrix函数来生成混淆矩阵。在训练模型时,将每个批次的预测结果和真实标签收集起来,最后调用这个函数就能得到整个数据集的混淆矩阵。PyTorch也有类似的功能,通过相应的函数可以实现相同的目的。这些深度学习框架生成的混淆矩阵可以与模型的训练过程紧密结合,方便开发者实时监控模型的性能。而Snipaste与模型训练过程完全无关,它无法参与到机器学习模型的开发和评估环节中。
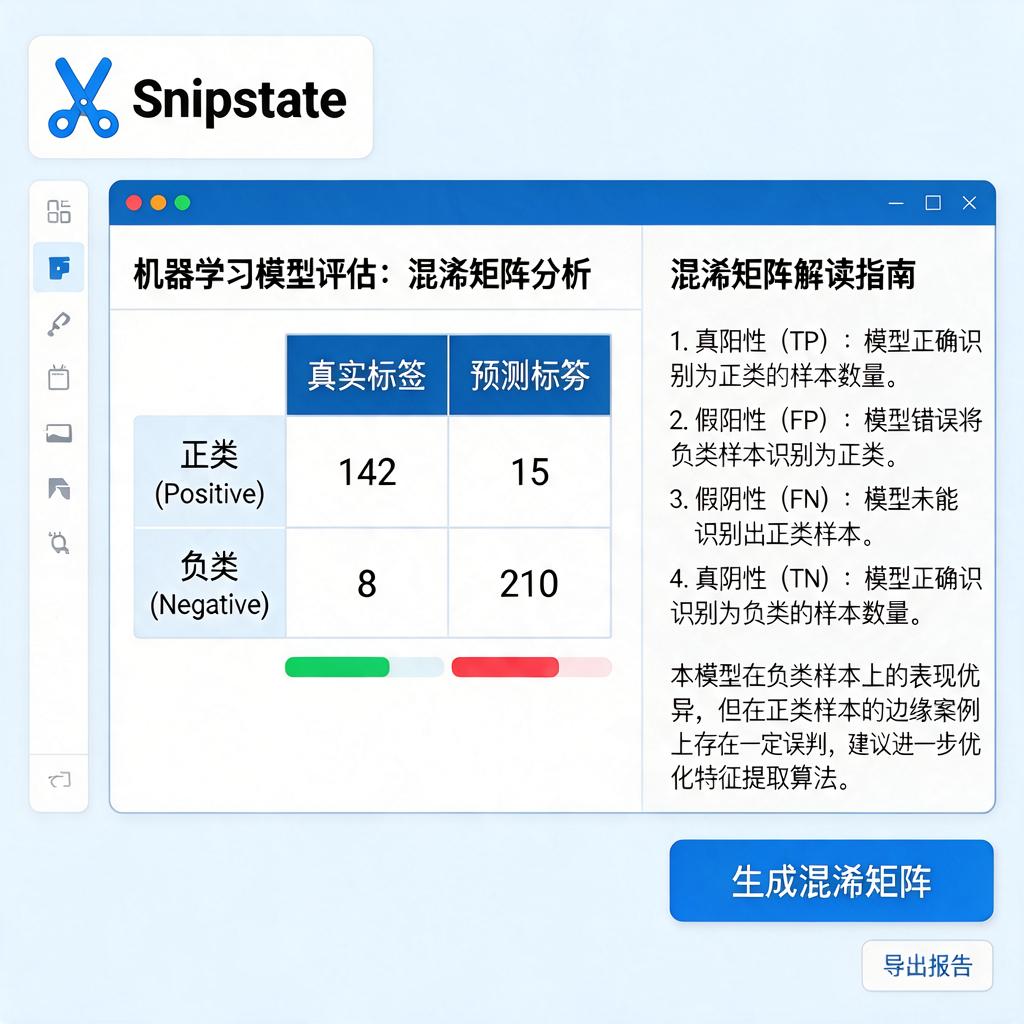
综上所述,Snipaste与Scikit - learn、Matplotlib、Seaborn、TensorFlow、PyTorch等工具在生成机器学习混淆矩阵方面有着本质的区别。Snipaste主要用于截图和图片标注,不具备生成和分析混淆矩阵的能力;而上述工具则是专门为机器学习和数据处理设计的,能够方便地生成数值或可视化的混淆矩阵,帮助开发者评估模型性能。如果你需要进行机器学习模型的评估,生成混淆矩阵,建议选择这些专业的工具。