截图文字实体关系抽取有哪些方法和技术?
截图文字实体关系抽取
from aip import AipOcr
APP_ID = '你的AppID' API_KEY = '你的ApiKey' SECRET_KEY = '你的SecretKey' client = AipOcr(APP_ID, API_KEY, SECRET_KEY)
def get_file_content(filePath):
with open(filePath, 'rb') as fp:
    return fp.read()
image = get_file_content('截图文件路径.jpg')
result = client.basicGeneral(image)
text = '' for item in result['words_result']:
text += item['words']
print(text)
截图文字实体关系抽取方法有哪些?
截图文字实体关系抽取是自然语言处理领域里一个重要任务,主要目的是从截图中的文字信息里识别出实体以及它们之间的关系。以下是几种常用的截图文字实体关系抽取方法,详细介绍给完全不熟悉这个领域的小白用户。
第一种方法是基于规则的方法。这种方法依赖于人工制定的规则来识别实体和关系。具体来说,需要先定义好实体类型,比如人名、地名、组织名等,再定义实体之间可能存在的关系类型,比如“属于”、“位于”等。接着,编写规则来匹配截图中的文字,找出符合定义的实体和关系。例如,可以编写规则“如果两个词之间有‘的’字,并且前一个词是人名,后一个词是组织名,则它们之间存在‘属于’关系”。这种方法简单直接,但需要大量人工编写规则,且对规则的覆盖度和准确性要求很高。
第二种方法是基于统计机器学习的方法。这种方法利用大量的标注数据来训练模型,让模型自动学习实体和关系的特征。具体来说,需要先准备大量标注好的截图文字数据,其中标注了实体和关系。然后,选择合适的机器学习算法,比如支持向量机、决策树等,来训练模型。训练好的模型可以对新的截图文字进行实体关系抽取。这种方法相比基于规则的方法,减少了人工编写规则的工作量,但需要大量标注数据,且模型的性能受数据质量和数量的影响很大。
第三种方法是基于深度学习的方法。近年来,深度学习在自然语言处理领域取得了巨大成功,也被广泛应用于实体关系抽取任务。具体来说,可以使用卷积神经网络、循环神经网络或Transformer等深度学习模型来处理截图文字。这些模型可以自动学习文字的语义特征,从而更准确地识别实体和关系。例如,可以使用预训练的语言模型(如BERT、GPT等)来提取文字的特征,再接一个分类层来预测实体和关系。这种方法不需要大量人工编写规则,且对数据的依赖相对较小,但需要强大的计算资源和较长的训练时间。
第四种方法是结合多种方法的方法。在实际应用中,单一的方法可能难以达到理想的抽取效果。因此,可以将多种方法结合起来使用。比如,可以先使用基于规则的方法进行初步抽取,再使用基于统计机器学习或深度学习的方法进行精细抽取。或者,可以将不同方法的抽取结果进行融合,以提高抽取的准确性和召回率。这种方法可以充分发挥各种方法的优势,提高实体关系抽取的整体性能。
以上几种方法各有优缺点,选择哪种方法取决于具体的应用场景和需求。对于初学者来说,可以从基于规则的方法开始尝试,逐步了解实体关系抽取的基本原理和流程。随着经验的积累和技能的提升,再尝试使用更复杂的方法来提高抽取效果。
截图文字实体关系抽取工具推荐?
如果你正在寻找好用的截图文字实体关系抽取工具,这里有几款实用且操作简单的工具推荐,适合不同场景和需求,即使是技术小白也能快速上手。
第一款是 ABBYY FineReader。它是一款功能强大的OCR(光学字符识别)软件,不仅能识别截图中的文字,还能对文字内容进行结构化分析,提取实体关系。操作步骤非常简单,打开软件后,选择“截图识别”功能,框选需要识别的区域,软件会自动将截图中的文字提取出来。接着,利用其内置的实体关系分析模块,对提取的文字进行深度解析,识别出其中的实体(如人名、地名、机构名等)以及它们之间的关系。这款工具的识别准确率高,支持多种语言,适合处理复杂的文档截图,但它是付费软件,不过有试用版本可以先体验。
第二款推荐 百度OCR API。如果你有一定的编程基础,或者愿意尝试简单的集成操作,百度OCR API是一个不错的选择。它提供了强大的文字识别和实体关系抽取能力,通过调用API接口,可以快速实现截图文字的识别和关系抽取。首先,你需要注册百度智能云账号,开通OCR服务并获取API密钥。然后,按照官方文档的指引,使用代码(如Python)调用API,将截图上传并进行识别。识别结果会返回文字内容以及初步的实体关系信息,你可以根据需求进一步处理和分析。百度OCR API的优势在于其灵活性和可扩展性,适合开发者和企业用户,而且有免费额度可供使用。
第三款是 腾讯云OCR。与百度OCR类似,腾讯云OCR也提供了截图文字识别和实体关系抽取的功能。它的操作流程同样简单,注册腾讯云账号后,开通OCR服务并获取相关权限。通过调用API接口,上传截图文件,即可获得识别结果。腾讯云OCR在识别准确率和速度方面表现出色,还支持多种格式的截图文件。对于没有编程经验的用户,腾讯云也提供了图形化界面工具,可以通过简单的拖拽和点击操作完成截图文字的识别和关系抽取,降低了使用门槛。
还有一款适合小白的工具是 在线OCR网站——SmallPDF。它是一个综合性的PDF处理和OCR识别平台,也支持截图文字识别和实体关系抽取。你只需打开SmallPDF网站,选择“OCR”功能,上传截图文件(或直接粘贴截图),网站会自动进行文字识别。识别完成后,你可以手动查看和标注文字中的实体和关系,或者使用网站提供的一些简单工具进行初步分析。SmallPDF的优点是无需安装软件,直接在浏览器中操作,方便快捷,适合处理简单的截图文字任务,部分功能免费使用。
最后推荐 iLovePDF。这也是一个在线工具,除了常见的PDF处理功能外,也具备截图文字识别和实体关系抽取能力。操作方法与SmallPDF类似,上传截图后,选择OCR识别选项,等待识别完成。识别结果可以导出为文本文件,方便后续处理和分析。iLovePDF的界面简洁友好,操作直观,即使是初次使用的用户也能轻松上手,同样有免费版本可供使用。
这些工具各有特点,你可以根据自己的需求和使用场景选择合适的工具。如果追求高准确率和复杂功能,ABBYY FineReader、百度OCR API和腾讯云OCR是不错的选择;如果希望操作简单、方便快捷,在线工具SmallPDF和iLovePDF会更适合你。希望这些推荐能帮助你找到满意的截图文字实体关系抽取工具。
截图文字实体关系抽取准确率如何提高?
想要提高截图文字实体关系抽取的准确率,可以从多个方面入手,下面我会详细讲解每一步的操作方法,帮助你更好地理解和实践。
第一步,优化图像预处理流程。截图中的文字可能因为拍摄角度、光线、分辨率等因素导致识别困难。因此,在抽取文字之前,先对图像进行预处理是关键。可以尝试调整图像的亮度、对比度,使用锐化滤镜增强文字边缘,或者通过旋转、裁剪等操作将图像调整至最佳识别状态。这些操作都能有效提升后续文字识别的准确率。
第二步,选择高质量的OCR工具。OCR(光学字符识别)技术是将图像中的文字转换为可编辑文本的关键。市面上有许多OCR工具可供选择,但质量参差不齐。为了提高实体关系抽取的准确率,建议选择那些经过大量数据训练、识别准确率高的OCR工具。同时,也可以关注工具的更新日志,及时使用最新版本以获取更好的识别效果。
第三步,构建精准的实体识别模型。在得到OCR识别结果后,下一步是识别出文本中的实体,如人名、地名、组织名等。这需要构建一个精准的实体识别模型。可以选择使用深度学习框架,如TensorFlow或PyTorch,结合预训练的语言模型(如BERT、GPT等)进行微调,以适应特定领域的实体识别任务。模型训练时,要确保数据集的多样性和标注的准确性,这是提高模型泛化能力和识别准确率的基础。
第四步,设计有效的关系抽取算法。在识别出实体后,需要进一步抽取实体之间的关系。这可以通过设计规则引擎、使用图神经网络或基于深度学习的关系抽取模型来实现。规则引擎适用于关系模式较为固定且简单的场景;图神经网络则能够处理复杂的实体间关系,通过节点和边的表示学习来捕捉关系信息;而基于深度学习的关系抽取模型则能够自动从大量数据中学习关系模式,适用于关系多样且复杂的场景。根据实际需求选择合适的方法,并不断优化算法以提高关系抽取的准确率。
第五步,持续迭代与优化。提高截图文字实体关系抽取的准确率是一个持续的过程。在实际应用中,要不断收集用户反馈和错误案例,分析错误原因并针对性地进行优化。比如,如果发现某些特定类型的实体或关系经常被错误识别,可以增加相关数据集进行模型再训练;如果发现图像预处理步骤存在不足,可以尝试引入新的图像处理技术进行改进。通过持续迭代与优化,不断提升系统的整体性能。
通过以上五个步骤的实践和改进,相信你可以有效提高截图文字实体关系抽取的准确率。记住,这是一个需要耐心和细心的过程,但只要坚持下去,你一定能够取得令人满意的成果。
截图文字实体关系抽取应用场景有哪些?
截图文字实体关系抽取是一项非常实用的技术,它能够从截图中的文字信息里识别出实体以及实体之间的关系,在多个领域都有广泛的应用场景。
在金融领域,截图文字实体关系抽取能发挥重要作用。比如,在处理金融新闻截图时,它可以快速识别出涉及的公司、股票代码、金融产品名称等实体,还能分析出这些实体之间的关系,像某公司推出了新的金融产品,或者某股票与宏观经济指标之间的关联。通过这种方式,金融从业者可以更高效地获取关键信息,辅助投资决策、风险评估等工作。对于投资者来说,也能及时了解市场动态,把握投资机会。
医疗行业同样离不开截图文字实体关系抽取。在医学研究文献截图、病历截图等场景中,该技术可以识别出疾病名称、症状、治疗方法、药物名称等实体。例如,从病历截图中能分析出患者所患疾病与症状之间的对应关系,以及医生所采用的治疗方法与药物之间的搭配。这有助于医生更全面地了解患者病情,制定更精准的治疗方案,也能为医学研究提供有价值的数据支持,促进医学知识的积累和传播。
教育领域也是截图文字实体关系抽取的重要应用场景之一。在教材截图、教学课件截图、学术论文截图等资料中,它可以识别出知识点、概念、人物、事件等实体。比如,在历史教材截图中,能分析出历史事件发生的时间、地点、参与人物以及事件之间的因果关系等。教师可以利用这些信息更好地组织教学内容,学生也能更清晰地理解知识体系,提高学习效率。
在电商行业,截图文字实体关系抽取也大有用处。在商品详情截图、用户评价截图等场景中,它可以识别出商品名称、品牌、规格、价格、用户评价关键词等实体。例如,从用户评价截图中能分析出用户对商品各方面的满意度以及商品存在的问题,商家可以根据这些信息优化商品描述、改进产品质量,提升用户体验和店铺口碑。
在新闻媒体领域,截图文字实体关系抽取有助于快速处理大量的新闻截图。它可以识别出新闻事件中的主体、时间、地点、事件内容等实体,以及这些实体之间的关系。记者和编辑可以利用这些信息快速了解新闻要点,进行新闻报道的撰写和编辑,提高新闻生产和传播的效率。
在法律领域,截图文字实体关系抽取可以应用于法律文书截图、案件资料截图等场景。它能够识别出案件当事人、法律条款、案件事实等实体,以及它们之间的逻辑关系。这有助于律师和法官更准确地理解案件情况,查找相关法律依据,提高案件处理的效率和公正性。
总之,截图文字实体关系抽取在金融、医疗、教育、电商、新闻媒体、法律等多个领域都有着广泛的应用,为各行业的信息处理和决策提供了有力的支持。
截图文字实体关系抽取实现原理是什么?
截图文字实体关系抽取的实现原理主要涉及几个关键步骤,这些步骤帮助计算机从图片中识别文字并理解它们之间的关系。下面详细解释一下整个过程,尽量用简单易懂的语言来说明。
首先,需要从截图里提取出文字。这一步通常使用光学字符识别技术,简称OCR。OCR技术能够分析图片中的像素,识别出文字的形状,然后转换成计算机可以处理的文本格式。这个过程有点像我们人类阅读文字,但计算机是通过算法来“看”和“理解”文字的。
接下来,有了提取出来的文本之后,就需要进行实体识别。实体识别是自然语言处理中的一个重要任务,它的目标是找出文本中具有特定意义的实体,比如人名、地名、组织名等。计算机通过训练好的模型来识别这些实体,模型通常是基于大量标注好的数据训练出来的,能够学习到哪些词汇组合在一起构成实体。
然后,识别出实体之后,就要分析它们之间的关系了。这一步叫做关系抽取。关系抽取也是自然语言处理的一部分,它通过分析文本中实体之间的上下文、语法结构等信息,来判断实体之间是否存在某种关系,以及这种关系的类型。比如,在一个句子中,“苹果”和“公司”可能通过“是”这个词连接起来,表示“苹果”是一个“公司”,这样计算机就能理解它们之间的关系了。
在实际操作中,这些步骤可能会结合在一起,使用深度学习等先进技术来提高准确性和效率。深度学习模型能够自动学习文本中的复杂模式,从而更准确地识别实体和关系。而且,随着技术的不断发展,这些模型也在不断优化和改进,使得截图文字实体关系抽取的效果越来越好。
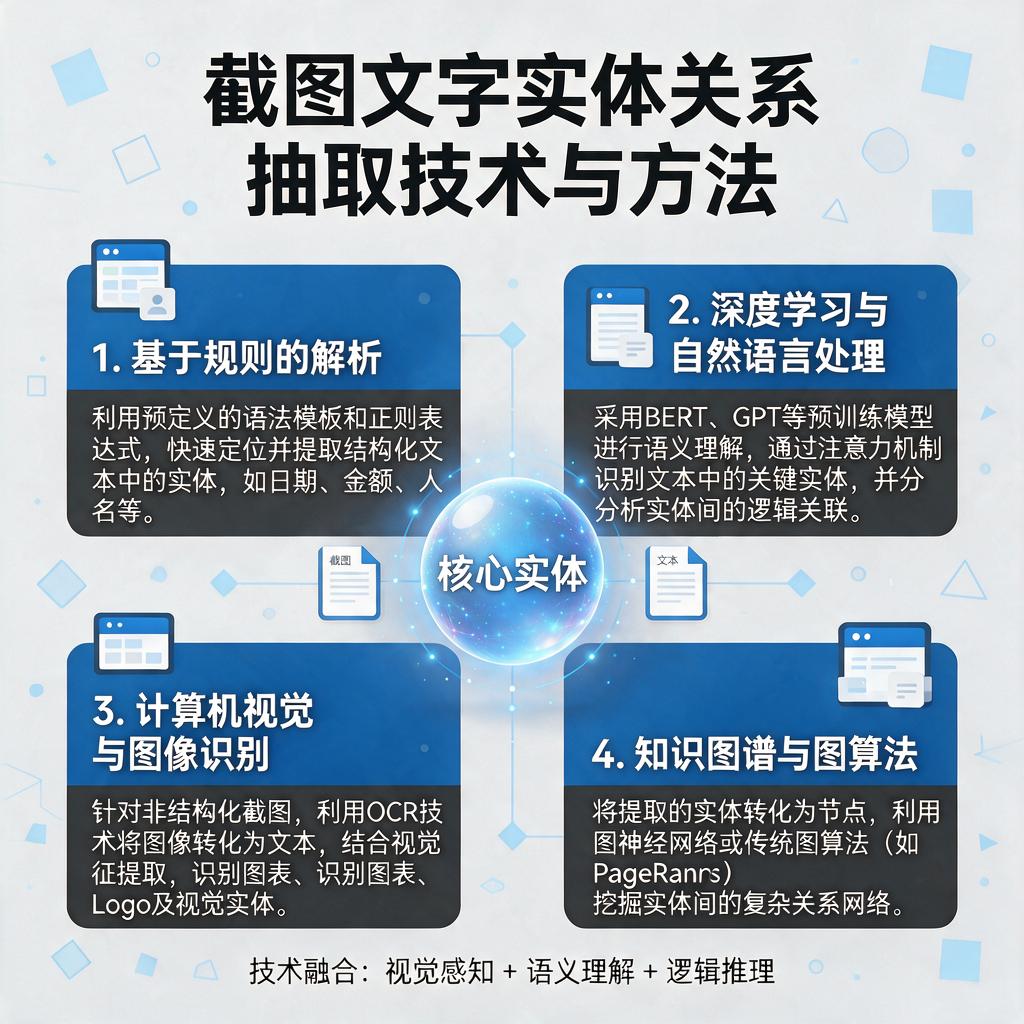
总的来说,截图文字实体关系抽取的实现原理就是先通过OCR技术提取文字,再用实体识别技术找出文本中的实体,最后通过关系抽取技术分析实体之间的关系。这个过程虽然听起来复杂,但实际上计算机已经能够很好地完成这些任务了,并且在实际应用中发挥着重要作用。