如何用简单方法实现截图文字词汇频率统计?
截图文字词汇频率统计
想要完成截图文字的词汇频率统计,对于小白用户来说,虽然听起来有点复杂,但只要跟着步骤一步步来,其实并不难。下面,我会详细介绍整个过程,确保你能轻松上手。
第一步,准备截图和识别文字。你得先有一张包含文字的截图。截图完成后,如果图片中的文字不是直接可编辑的文本格式,就需要使用OCR(光学字符识别)工具来将图片中的文字转换成可编辑的文本。市面上有很多OCR工具可以选择,比如在线的OCR网站,或者手机上的OCR应用,它们大多操作简便,只需上传图片,点击识别,就能得到文字内容。
第二步,整理识别出的文字。OCR识别出来的文字可能会有一些错误或者格式问题,比如多余的空格、换行符,或者个别识别错误的字。这时候,你需要花点时间手动检查一下,把文字整理得干净整齐。这一步虽然有点繁琐,但为了后续统计的准确性,是必不可少的。
第三步,选择统计工具。整理好文字后,接下来就要选择一个合适的工具来进行词汇频率统计了。如果你对编程有一定了解,可以使用Python这样的编程语言,配合相应的库(如jieba分词库)来编写一个简单的统计程序。但如果你对编程不熟悉,也没关系,市面上有很多现成的文本分析工具或者在线服务,它们通常都提供了词汇频率统计的功能。你只需要把整理好的文字粘贴进去,点击统计,就能得到结果了。
第四步,查看并分析统计结果。统计完成后,你会得到一个词汇频率的列表,里面列出了每个词汇以及它们出现的次数。这时候,你可以根据需要,对结果进行进一步的分析。比如,你可以找出出现频率最高的几个词汇,看看它们是否和你预期的一样;或者,你可以根据词汇的频率,对文本的主题或者内容进行一个初步的判断。
第五步,保存和分享统计结果。如果你对统计结果满意,就可以把它们保存下来了。大多数文本分析工具或者在线服务都提供了导出功能,你可以把结果导出成Excel表格或者CSV文件,方便后续的处理和分析。如果你需要和别人分享你的统计结果,也可以直接把导出的文件发给他们,或者把统计结果的截图发给他们看。
总的来说,截图文字的词汇频率统计虽然需要一些步骤,但只要跟着上面的流程一步步来,即使是小白用户也能轻松完成。希望这个详细的介绍能帮到你,让你在处理类似任务时更加得心应手!
截图文字词汇频率统计的方法有哪些?
想要进行截图文字词汇频率统计,其实有多种方法可以实现,下面就详细介绍几种常见且实用的操作步骤,帮助你轻松完成这项任务。
第一种方法是使用OCR识别软件结合文本处理工具。首先,你需要选择一款OCR(光学字符识别)软件,这类软件能将图片中的文字转换成可编辑的文本格式。市面上有很多这样的软件,比如Adobe Acrobat、ABBYY FineReader或者一些在线的OCR工具。安装并打开软件后,导入你的截图文件,按照软件提示进行文字识别操作。识别完成后,将得到的文本保存下来。接下来,使用文本处理工具,比如Microsoft Word或者Notepad++,打开保存的文本文件。在Word中,你可以利用“查找”功能配合“高级查找和替换”来统计特定词汇的出现次数;在Notepad++中,则可以使用“查找”对话框中的“计数”功能,或者安装一些专门的插件来统计词汇频率。
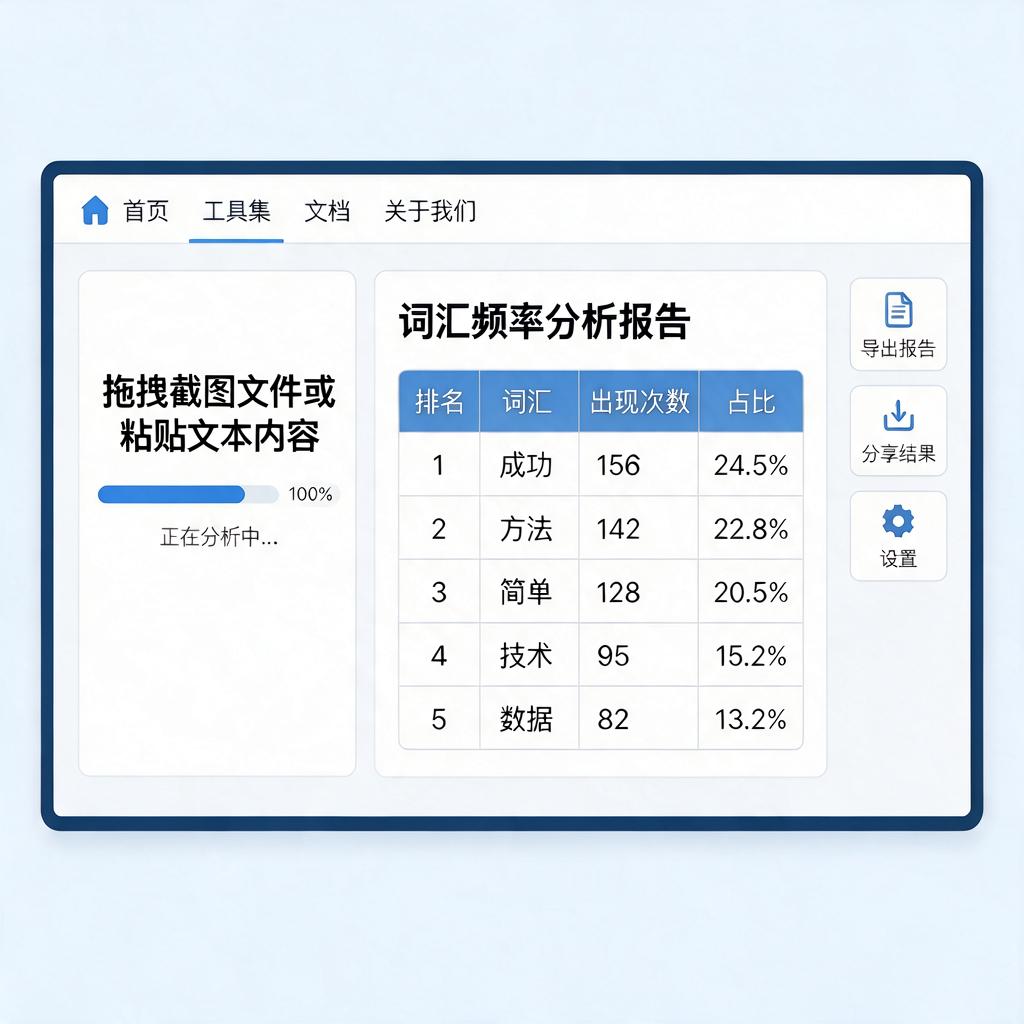
第二种方法是直接使用在线词汇频率统计工具。现在网络上有很多免费的在线工具,它们不仅能识别图片中的文字,还能直接统计词汇出现的频率。你只需要搜索“图片文字词汇频率统计”或者类似的关键词,就能找到不少这样的工具。使用这类工具时,通常只需要上传你的截图文件,然后等待工具处理完成。处理完成后,工具会显示一个词汇频率统计表,你可以清楚地看到每个词汇出现的次数以及占比情况。这种方法简单快捷,非常适合不想安装额外软件或者对技术操作不太熟悉的用户。
第三种方法则是利用编程技能来实现。如果你有一定的编程基础,比如熟悉Python语言,那么你可以使用Python中的OCR库(如pytesseract)和文本处理库(如collections中的Counter)来编写一个简单的脚本。这个脚本首先会利用OCR库识别截图中的文字,然后将识别出的文字转换成字符串格式。接着,利用Counter库对字符串中的词汇进行计数,最后输出一个词汇频率统计结果。这种方法虽然需要一定的编程知识,但一旦编写完成,就可以重复使用,非常适合需要频繁进行此类统计工作的用户。
无论选择哪种方法,进行截图文字词汇频率统计时都要注意确保识别的准确性。OCR识别过程中可能会因为图片质量、字体大小、颜色对比度等因素导致识别错误,因此在统计前最好对识别出的文本进行仔细校对,确保统计结果的准确性。希望这些方法能帮助你顺利完成截图文字词汇频率的统计工作!
截图文字词汇频率统计工具推荐?
想要统计截图文字中的词汇频率,其实有不少实用工具可以帮到你。这类工具能自动识别图片中的文字,然后统计每个词汇出现的次数,特别适合需要分析大量文本数据的时候。下面就给你推荐几款好用的工具,操作简单,适合新手小白。
第一款是“ABBYY FineReader”。这是一款专业的OCR识别软件,识别准确率很高。用它来统计截图文字的词汇频率,步骤很简单。先打开软件,把截图导入进去,软件会自动识别图片中的文字。识别完成后,把文字内容复制到Excel或者Word里,再用Excel的“数据透视表”功能,或者Word的“查找”功能配合手动计数,就能轻松统计出每个词汇出现的次数。虽然需要借助其他软件完成最后统计,但ABBYY FineReader的识别效果绝对值得一试。
第二款推荐“在线OCR工具+词汇统计网站”的组合。比如“iLovePDF”的OCR功能,它是在线工具,不用下载安装,直接上传截图就能识别文字。识别完成后,把文字复制下来。接着,可以用“WordCounter”这样的在线词汇统计网站,把文字粘贴进去,它会自动统计每个词汇的频率,还能生成详细的报告,包括词汇总数、不同词汇的数量、出现频率最高的词汇等等。这种方式完全免费,操作也方便,适合不想下载软件的用户。
第三款是“Adobe Acrobat Pro”。如果你经常需要处理PDF文件,这款软件会很实用。它也有OCR功能,可以识别截图中的文字。打开软件后,导入截图,用OCR识别文字,然后把文字导出为文本格式。接下来,可以用软件自带的“搜索”功能,手动统计每个词汇的出现次数,或者把文字复制到Excel里,用公式统计频率。虽然步骤稍微多一点,但Adobe Acrobat Pro的功能很强大,适合有更多文档处理需求的用户。
还有一款是“Snipaste”搭配“Python脚本”。Snipaste是一款截图工具,截图后可以把图片保存下来。然后用Python写一个简单的脚本,调用OCR库(比如Tesseract)识别图片中的文字,再用Python的字典或者集合来统计词汇频率。这种方式适合有一定编程基础的用户,虽然需要写代码,但灵活性很高,可以自定义统计规则,比如忽略大小写、去除标点符号等等。
如果不想用专业软件,也不想写代码,还可以试试“QQ截图+微信小程序”。先用QQ截图截取需要的文字区域,然后保存图片。接着在微信里搜索“OCR识别”或者“词汇统计”相关的小程序,上传图片,小程序会自动识别文字并统计词汇频率。这种方式完全免费,操作简单,适合偶尔需要统计词汇频率的用户。
选工具的时候,可以根据自己的需求来。如果追求高准确率,推荐ABBYY FineReader或者Adobe Acrobat Pro;如果想要免费又方便,可以试试在线工具组合或者微信小程序;如果有编程基础,想自定义统计规则,Python脚本是个不错的选择。希望这些推荐能帮到你,轻松完成截图文字的词汇频率统计!
如何用Python实现截图文字词汇频率统计?
from PIL import Image import pytesseract import re from collections import Counter
image = Image.open('screenshot.png')
text = pytesseract.image_to_string(image)
words = re.findall(r'\b\w+\b', text.lower())
word_counts = Counter(words)
for word, count in word_counts.items():
print(f'{word}: {count}')